Ein LLM-Wiki statt RAG
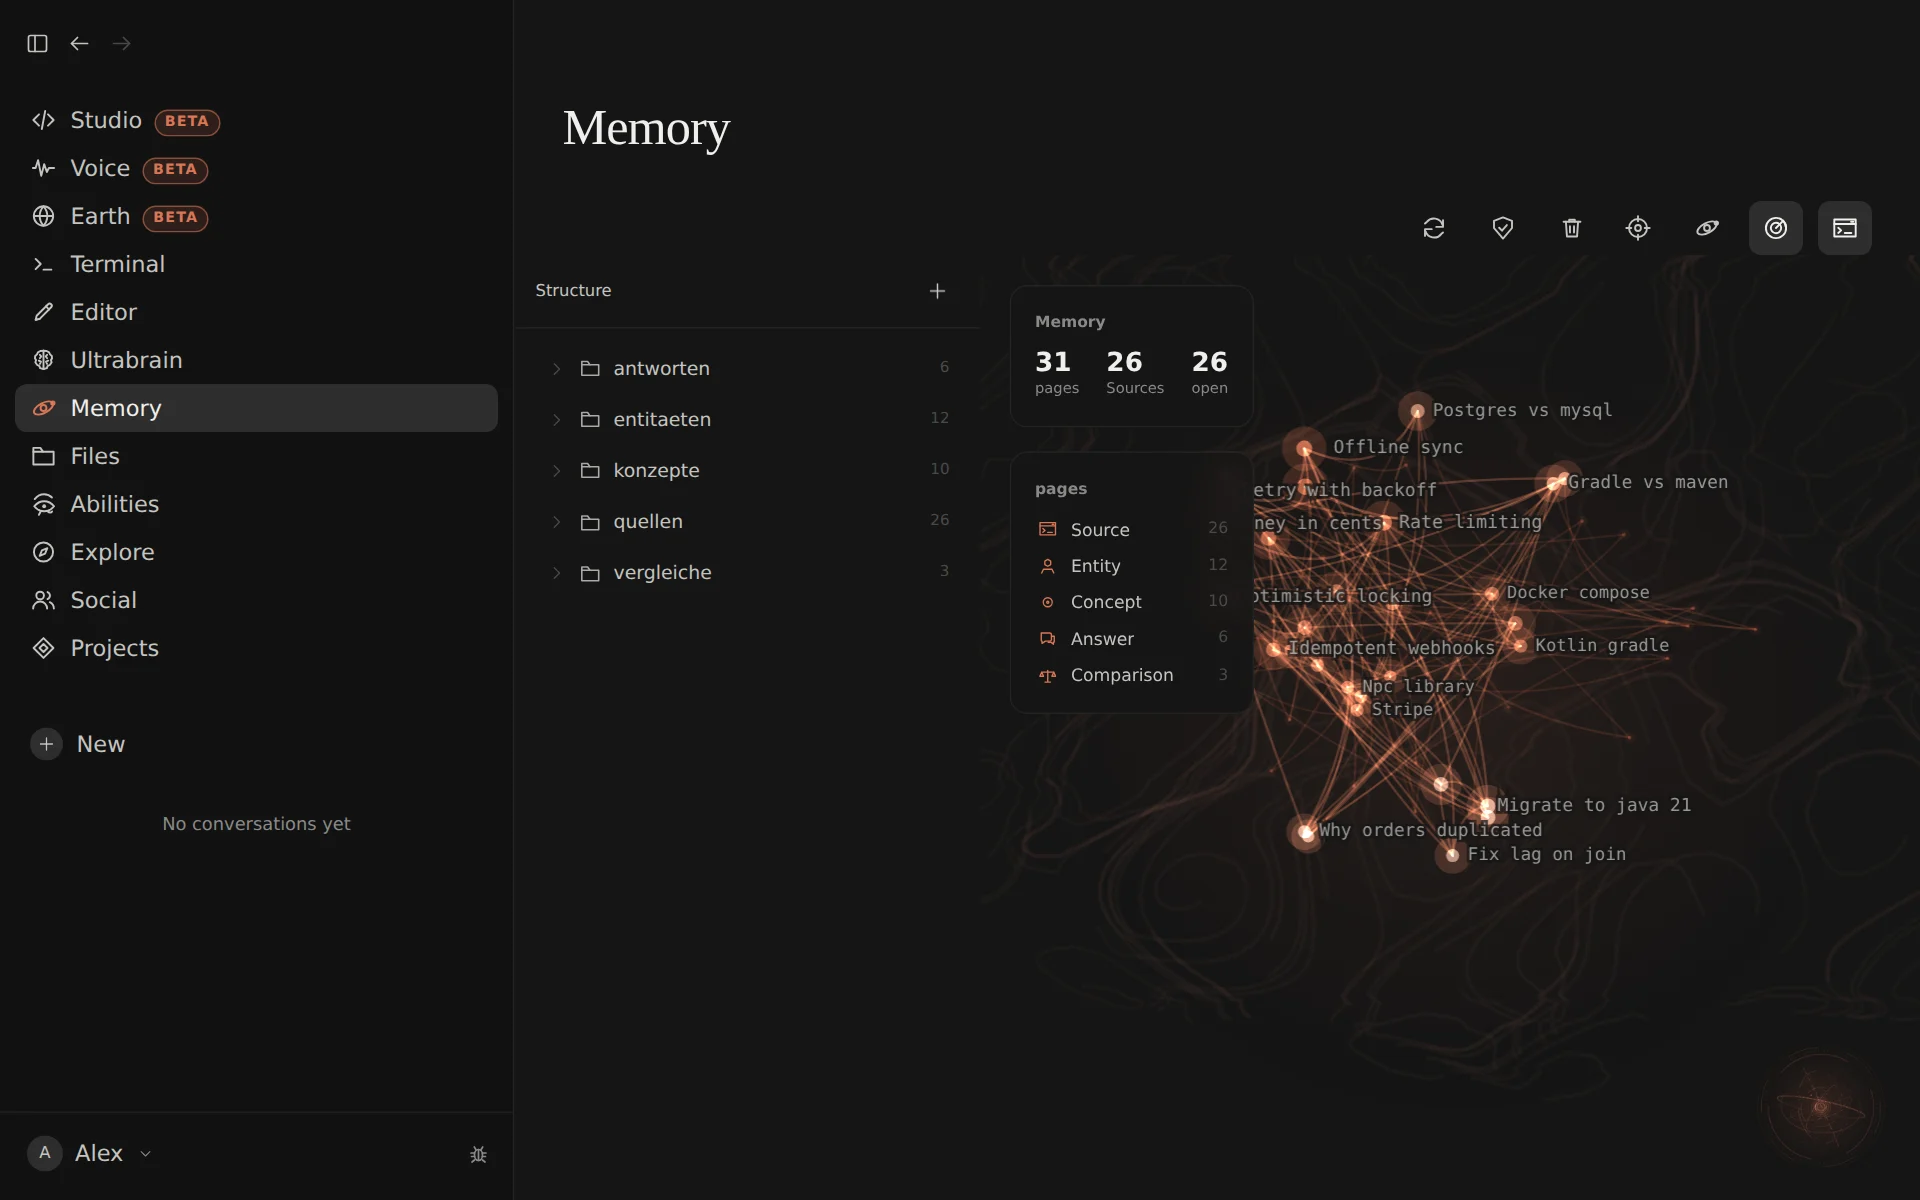
Osiris gibt Claude ein Langzeitgedächtnis. Eine Vektordatenbank braucht es dafür nicht, sondern das Muster, das Andrej Karpathy als „LLM-Wiki“ beschrieben hat: Nach jeder Unterhaltung liest ein eigener Lauf, was gesagt wurde, und schreibt es in Markdown-Seiten. Das Wissen wird beim Schreiben kompiliert — und nicht bei jeder Frage neu zusammengesucht.
Was RAG tut — und was es offen lässt
Retrieval-Augmented Generation, kurz RAG, zerschneidet Dokumente in Stücke, macht Vektoren daraus und holt bei jeder Frage die Stücke, die am ähnlichsten aussehen. Für große Dokumentensammlungen funktioniert das. Als Gedächtnis für die eigene Arbeit hat es einen Haken: Jede Frage beginnt wieder beim Rohmaterial. Zwei Stücke, die sich widersprechen, kommen beide zurück, und was in einer Unterhaltung verstanden wurde, ist in der nächsten nicht da — das Modell muss es jedes Mal neu zusammensetzen.
Das LLM-Wiki: einmal kompilieren, dann nachschlagen
Karpathys Idee dreht die Reihenfolge um. Das Verstehen passiert vorher: Das Modell liest eine Quelle einmal, fasst sie zusammen und legt das Gelernte unter den Themen ab, zu denen es gehört — es ergänzt eine Seite, die es schon gibt, statt eine zweite daneben zu schreiben. Gesucht wird später nicht mehr im Rohmaterial, sondern in Seiten, die schon geschrieben, verknüpft und geprüft sind. In Osiris ist das das Memory: das Innere des Gehirns, was es sich auf Dauer merkt.
Drei Schichten mit klarem Eigentum
- raw/ — die Quellen: jede Unterhaltung und jede Datei, die du dort ablegst, unverändert. Der Agent liest sie und schreibt sie nie um.
- wiki/ — die Seiten, die der Agent schreibt: Entitäten, Konzepte, je Quelle eine Zusammenfassung, Vergleiche und Antworten, die es wert waren. Das Schema verlangt, dass jeder Absatz die Quelle nennt, aus der er stammt.
- schema.md — die Regeln des Memory: wie Seiten geschrieben werden und wann eine Seite ergänzt statt verdoppelt wird. Eine Datei, die du lesen und ändern kannst.
Daneben führt Osiris selbst zwei Dateien: index.md, die Karte aller Seiten mit je einem Satz, und log.md, eine Zeile je Vorgang, nur angehängt. Nichts geschieht unbemerkt.
Einlesen, fragen, pflegen
- Einlesen — zehn Minuten nach der letzten Nachricht einer Unterhaltung, einmal je Unterhaltung. Das Schema gibt dem Lauf vor, genau eine Zusammenfassung der Quelle zu schreiben, die Seiten zu ergänzen, die sie berührt, und eine Seite, der die neue Quelle widerspricht, zu berichtigen und den Widerspruch mit Datum und Beleg zu nennen.
- Fragen — erst die Karte, dann gezielt die Seiten, die passen. Das Schema verlangt Antworten, die sagen, auf welcher Seite und welcher Quelle sie beruhen, und dass eine Synthese, die es so noch nicht gab, als neue Antwortseite abgelegt wird.
- Pflegen — von Haus aus einmal pro Woche: Widersprüche zwischen Seiten, überholte Aussagen, verwaiste Seiten, fehlende Querverweise und Quellen ohne Zusammenfassung.
Gefunden auf Deutsch und auf Englisch
Jede Seite trägt im Kopf zwei zusätzliche Felder: aliases, andere Namen für dieselbe Sache — in beiden Sprachen, mit Abkürzungen und alten Namen —, und fragen, die Fragen, die sie beantwortet, so gestellt, wie jemand fragt, der die Antwort noch nicht kennt. So wird eine Seite auch dann gefunden, wenn die Frage andere Wörter benutzt als die Seite.
Memory und Gehirn: was war, was gilt
Das Memory liegt neben dem Gehirn, nicht darin. Das Gehirn hält fest, was gilt — Regeln, Notizen, Entscheidungen, die du aufschreibst und nach denen Claude sich richtet. Das Memory hält fest, was war — verdichtet aus deinen Unterhaltungen. Das eine bindet, das andere erinnert. Wie Claude an beides kommt, steht unter Claude Code mit Gedächtnis.
Reines Markdown auf deiner Platte
Das Memory ist ein Ordner voller Markdown-Dateien auf deinem Rechner. Du kannst die Seiten lesen, in Obsidian öffnen oder unter Git stellen. An Anthropic geht nur, was eine einzelne Anfrage braucht. Und wie jedes Gedächtnis kann es sich irren: Was Osiris sich gemerkt hat, war einmal richtig — der wöchentliche Pflegelauf sucht Widersprüche, aber er findet nicht jeden.